Cosa misurano davvero i dodici sistemi di rilevamento dell’IA quando valutano i nostri testi
Abbiamo sottoposto uno dei nostri articoli a dodici strumenti di rilevamento dell’IA, cercando di capire quale fosse la versione più credibile dal punto di vista dell’autenticità umana. I nostri strumenti automatici non sono riusciti a mettersi d’accordo praticamente su nulla.
Chiunque scriva per mestiere oggi ha una preoccupazione tipica dei nostri tempi. Finisci un articolo, ne sei abbastanza soddisfatto, e poi una vocina ti chiede se qualche software stia per decidere che in realtà non l’hai mai scritto. Gli editori se ne preoccupano, i clienti fanno domande al riguardo, ed è nato un piccolo settore che, a quanto pare, dovrebbe risolvere la questione, spesso in cambio di un canone mensile.
Siamo chiari sul motivo per cui questo dilemma è importante per noi. Stiamo selezionando i contributi di un gruppo di autori diversi, con abilità di scrittura variabili. Molti si avvalgono di un piccolo aiuto dall’IA per la ricerca o per dare l’ultimo ritocco ai propri articoli. Prima che qualsiasi contenuto venga pubblicato, di solito lo sottoponiamo a ZeroGPT per evitare di pubblicare contenuti con punteggi IA elevati, che potrebbero essere penalizzati da Google Search e risultare inquietanti per i lettori.
Quando la nostra articolo “Un’estate italiana a Positano” ha totalizzato appena il 4,4% di AI, quel numero mi è sembrato quasi una bomba d’amore finta e stranamente basso per un articolo che aveva beneficiato di un po’ di assistenza automatizzata durante la stesura. I miei colleghi scrittori al 100% umani erano un po’ seccati che i loro articoli originali, scritti così bene, a volte ottenessero punteggi intorno alla metà dei 10.
Un risultato così lusinghiero fa sorgere qualche dubbio, così abbiamo deciso di fare un esperimento mettendo i robot l’uno contro l’altro per sentire altre opinioni.
Il nostro articolo in primo piano, “Un’estate italiana a Positano”, è un itinerario di due giorni ispirato al romanzo di Rebecca Serle ambientato sulla Costiera Amalfitana, che presto diventerà un film. L’articolo conta 2.116 parole e 12.458 caratteri. L’abbiamo poi incollato, senza modifiche, in dodici popolari strumenti di rilevamento dell’IA.
Il ragionamento era semplice. Se questi strumenti misurano qualcosa di reale, dovrebbero puntare più o meno nello stesso punto. Un testo porta o meno le impronte di un modello linguistico e, anche se ci si aspetterebbe qualche variazione marginale, dodici strumenti puntati sullo stesso oggetto dovrebbero essere sostanzialmente d’accordo su ciò che stanno osservando. Ma, come si è poi scoperto, era davvero chiedere troppo.
Da zero a cento
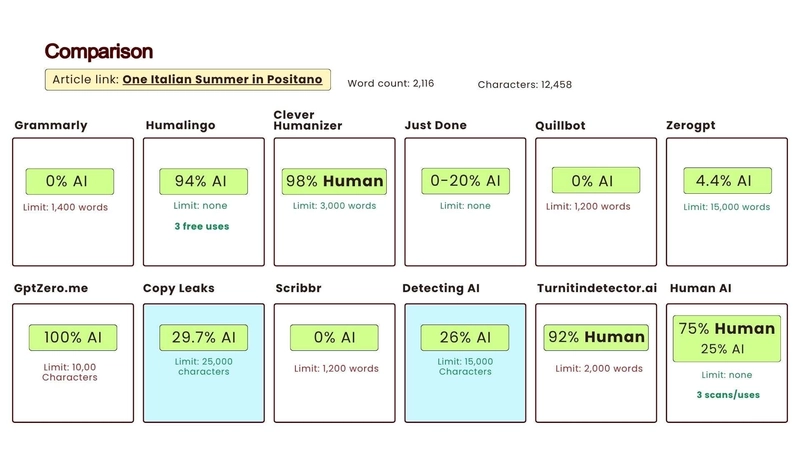
Ecco i risultati. Grammarly, QuillBot e Scribbr hanno rilevato tutti lo 0% di AI. ZeroGPT, il tool su cui di solito facciamo affidamento, ha annunciato, con una certa soddisfazione, che “Il tuo testo è scritto da un essere umano”, stimando il contributo della macchina al 4,4%. Il rilevatore di Clever Humanizer ha giudicato l’articolo umano al 98%, aggiungendo che «quasi tutte le frasi e lo stile di scrittura nel complesso sembrano umani», mentre Turnitindetector.ai lo ha seguito da vicino con il 92% umano, il 7% misto e l’1% di IA. Just Done ha fornito una stima non definitiva compresa tra 0 e 20%. Poi c’è stato un gruppo nel mezzo: WriteHuman al 25% di IA, Detecting AI al 26% (pur continuando a classificare il testo come “probabilmente scritto da un essere umano”), e Copyleaks al 29,7%, avendo classificato 629 parole nella categoria “IA” e 1.486 in quella “umana”. All’estremo opposto c’erano Humalingo, che ha stabilito che il testo fosse al 94% generato dall’IA, e GPTZero, che è arrivato fino al 100% e si è dichiarato “altamente sicuro” che fosse stato scritto da una macchina.
Quindi lo stesso articolo, a seconda di chi lo chiedessi, era o del tutto umano, o del tutto artificiale, oppure per circa un quarto sospetto. Un freelance un po’ nervoso che cercava di dimostrare la propria innocenza poteva semplicemente scegliere un testimone.

Per questo articolo in particolare, però, la via di mezzo mi è sembrata la soluzione più plausibile. Un articolo scritto con un po’ di aiuto dell’IA e una buona dose di revisione umana è, per definizione, un mix, e Copyleaks e Detecting AI sembravano essere quelli che descrivevano proprio quel mix, invece di arrotondarlo al ribasso come “innocente” o al rialzo come “colpevole”. La ripartizione di Copyleaks (29,7% IA e 70,3% umano) e quella di Detecting AI (26% con l’etichetta “probabilmente scritto da un essere umano”) sono più vicine a come l’articolo è stato effettivamente realizzato rispetto a uno zero netto o a un cento sicuro. Ovviamente si tratta di un giudizio su un solo articolo e non è una prova che nessuno dei due strumenti abbia sempre ragione.

Risultato della scansione di rilevamento AI

Risultati della scansione di Copyleaks
In parte, il disaccordo ha una spiegazione banale, e vale la pena essere obiettivi al riguardo. Molti degli strumenti gratuiti non leggono mai l’articolo per intero. L’analisi di Grammarly si ferma a 1.400 parole, quella di QuillBot e Scribbr a 1.200 (il contatore di QuillBot segnava 1.139), quello di GPTZero a 10.000 caratteri contro i nostri 12.458, e quello di Turnitindetector.ai a 2.000 parole. Un bel po’ di questi verdetti, in entrambi gli estremi, riguardavano solo un estratto. Questo però spiega meno di quanto potresti sperare. Sia Grammarly che GPTZero hanno letto l’inizio del testo, gli stessi paragrafi sulla valigia, i due biglietti aerei e il viaggio che avrebbe dovuto fare con sua madre. Grammarly non ha rilevato alcun modello tipico dell’IA in essi. GPTZero li ha evidenziati frase per frase.

Prove che dimostrano che Scribbr usa Quillbot come strumento di rilevamento dell’IA

C’è anche una lezione più sottile nascosta dietro questi numeri. Il pannello dei risultati di Scribbr riporta il marchio e il numero di modello di QuillBot, e i due hanno restituito risultati identici: 0% IA, 0% misto, 100% umano. Quello che sembra un doppio parere indipendente è, a giudicare dagli screenshot, un unico parere espresso due volte. La concordanza tra i rilevatori è rassicurante solo se si tratta di strumenti davvero diversi, e non è sempre facile capirlo dall’esterno.
La frase su cui nessun bot è riuscito a concordare
La prova più rivelatrice sta proprio nelle frasi su cui gli strumenti hanno deciso di concentrarsi. Una frase in particolare è stata individuata più e più volte:
“Arriva in Costiera Amalfitana con tutto ciò che il dolore porta con sé, tra cui ricordi, domande senza risposta e quella sensazione sgradevole che la vita vada avanti senza la persona che la rendeva familiare.”
Detecting AI l’ha contrassegnato come “probabilmente generato dall’IA”. WriteHuman l’ha evidenziato in rosso. Anche GPTZero, che ha evidenziato praticamente tutto, ha evidenziato anche questo.

Rilevamento dell’IA: la frase viene contrassegnata come “probabilmente generata dall’IA”

WriteHuman ha evidenziato la frase in rosso

GPTZero, che ha evidenziato praticamente tutto, ha evidenziato anche questa frase.
È facile capire perché. La frase raggruppa tre elementi in un elenco ordinato, si basa su sostantivi astratti e si conclude con una cadenza delicatamente elegiaca, e i modelli linguistici sono notoriamente affezionati a tutte e tre queste caratteristiche. Un redattore potrebbe persino cavillare su questo punto: «tutte le cose che il dolore tende a portare con sé» è un modo un po’ contorto per introdurre l’elenco. Ma la regola del tre ha funzionato bene nella prosa umana per un paio di migliaia di anni prima che qualcuno creasse un chatbot, e una frase sul dolore può benissimo suonare un po’ come una frase sul dolore. Un rilevatore può dirti che una frase assomiglia a ciò che le macchine tendono a produrre. Non può dirti se qualcuno l’ha scelta apposta.
Altri segnali erano più difficili da spiegare. WriteHuman ha segnalato anche : “Le due avevano programmato da anni una vacanza a Positano, in parte perché Carol aveva trascorso un’estate lì prima di conoscere il padre di Katy e non smetteva mai di parlare di quel posto”, che è una semplice descrizione dell’ambientazione, del tipo che si trova in qualsiasi riassunto di un libro. L’unica cosa che sembra dare fastidio è proprio il fatto che sia chiaro e ben strutturato. Questo fa sorgere una possibilità scomoda per chiunque scriva di mestiere una prosa semplice e informativa: le qualità che rendono un testo facile da leggere potrebbero essere proprio quelle che lo fanno sembrare statisticamente sospetto.
La spiegazione scritta di Humalingo illustra chiaramente il problema. Ha segnalato che il testo “si basa su schemi sintattici ripetitivi, limitando la fluidità e la flessibilità naturali”, assegnando alla struttura delle frasi un punteggio di 1 su 5 (“Innaturale”) e alla leggibilità un punteggio di 3 su 5 (“Difficile da leggere”). Clever Humanizer, leggendo le stesse parole, ha ritenuto quasi tutte le frasi scritte da un essere umano. Leggi tu stesso l’inizio e vedrai che c’è un fondo di verità nella critica di Humalingo: i primi paragrafi procedono davvero in una marcia costante di fatti, una clausola dopo l’altra. Un redattore umano potrebbe benissimo variare quel ritmo. Si tratta però di una questione di stile, e un rilevatore non ha modo di separare la questione dello stile da quella della paternità del testo.
I “rilevatori” che vendono la cura
L’aspetto più significativo che si nota negli screenshot non c’entra quasi per niente con l’articolo. Un numero sorprendente di questi rilevatori si trova proprio accanto a un prodotto pensato proprio per aggirarli. Nel menu di Grammarly, l’AI Detector è a una scheda di distanza dall’AI Humanizer. Clever Humanizer prende il nome proprio dal prodotto che vende. Detecting AI include un “AI Humanizer” nella sua barra di navigazione. WriteHuman ha raggiunto il suo 25% con un grande pulsante “Humanize This” proprio sotto.
Just Done è andato oltre. Dopo aver valutato l’articolo con un punteggio AI compreso tra 0 e 20%, ha aggiunto un avviso rosso in cui si diceva che c’era “una probabilità del 73% di essere erroneamente segnalato come generato dall’IA” e ci ha invitato a “correggere i miei punti deboli”, con un abbonamento da 19,99 dollari al mese. Il messaggio, in sostanza, era che il testo probabilmente andava bene, che comunque rischiava di essere segnalato e che era disponibile un aiuto a pagamento.
È qui che entra in gioco la questione degli “humaniser”. Un “humaniser” è progettato per influenzare il punteggio di un rilevatore, il che lo rende significativo solo nella misura in cui soddisfa il rilevatore stesso. Se uno strumento classifica un testo come 0% AI e un altro come 100%, riscrivere il testo fino a farlo passare diventa una questione di scegliere quale “giudice” accontentare. Rielabora la frase sul lutto per farla superare il filtro “Detecting AI” e potresti perdere l’unica riga del paragrafo che trasmette davvero un’emozione. Il risultato sembrerebbe forse meno palesemente generato da una macchina, ma non sembrerebbe comunque qualcosa che una persona sceglierebbe davvero di scrivere.
Quello che i numeri non riescono a dire
Siamo andati alla ricerca di un verdetto su un articolo e ne siamo usciti con un’idea più chiara di cosa siano questi verdetti. Ogni strumento che abbiamo provato misurava quanto un testo assomigliasse al tipo di scrittura che un modello linguistico tende a produrre, e ognuno sembra misurare questa somiglianza in modo diverso, su diverse parti del testo, con idee diverse su cosa sia considerato sospetto. Nessuno di essi valutava se il testo fosse scritto bene, se dicesse qualcosa di vero o se dietro ogni frase ci fosse una persona che avesse deciso che doveva rimanere.
Queste sono domande di montaggio, e rimangono ostinatamente umane. L’inizio procede in modo troppo regolare? Probabilmente, un po’. La frase sul dolore merita davvero quella struttura in tre parti, o si limita a seguire uno schema già visto? È un argomento su cui vale la pena discutere davanti a un caffè. La frase finale, quella in cui dici che stai «visitando il luogo prima che lo faccia il film», è una svolta azzeccata? Noi pensiamo proprio di sì. Nessun punteggio risolve nulla, e uno strumento che riscrive una frase solo per cambiare un punteggio sta risolvendo un problema diverso da quello che ha effettivamente uno scrittore.
Se l’esperimento ci ha insegnato qualcosa, è che sembrare umani e sembrare meno simili a una macchina sono due cose diverse, e solo una delle due si può misurare con una percentuale. L’altra richiede ancora un lettore.
Punteggio di scrittura AI: non calcolato. I dodici rilevatori che abbiamo testato hanno assegnato allo stesso articolo punteggi compresi tra lo 0% e il 100%, quindi non c’è un unico metodo di valutazione da riportare qui. Per ottenere un dato relativo a questo articolo, dovresti analizzarlo con uno di quei rilevatori di cui ti fidi.